
LightFile Proxyは既存システムに後付けで導入される手軽さの一方、画像配信の単一障害点にもなる。仮にLightFile Proxyが落ちると、CloudFrontにキャッシュされていない画像がまったく表示されないという重大事故を引き起こす。
そこで二重の対策により、そのような事故を全力で回避する機構を備えている。落ちてもWebPにならないだけで、CloudFrontが本来のオリジンから直接取ってくる。瞬発的な不調をその場でよけるものと、長く続く障害に自動で対応するものの二段構えになっている。
連載「詳説 LightFile Proxy」
AWS CloudFrontの後ろに置いて、既存のサイトを変えずに画像をWebPで配信する仕組みを説明する連載。
- サイトに手を加えず画像をWebPで配信する仕組み
- 拡張子は.jpgのまま中身をWebPにしてよいのか
- 画像変換のタイミングとその最適解
- 次世代画像フォーマットの採用でどのくらい画像が軽くなるか
- WebP化によるデータ削減で見た目は劣化するか
- 画像のリンク切れを起こさない二重の障害対応(本記事)
- 無駄な変換を避け高速に画像を配信するためのキャッシュ戦略(10月1日公開予定)
- その他の細かな特徴(10月2日公開予定)
- AWS純正のDITで代替できるか(10月3日公開予定)
- 料金体系(10月4日公開予定)
土台はCloudFrontのオリジングループ
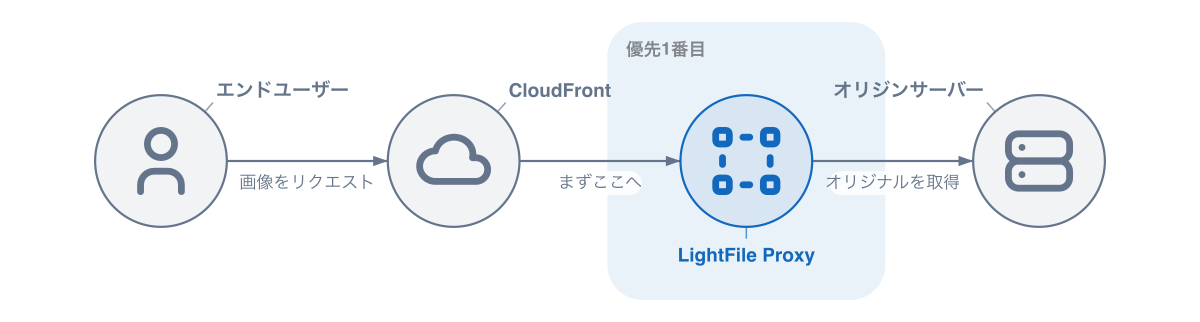
二段のどちらも、オリジングループという土台のうえに載っている。オリジンを複数登録して優先順を付けておくと、1番目が失敗したときに2番目へ取りに行ってくれる仕組みで、これはLightFile Proxyの機能ではなくCloudFrontの機能になる。導入時の設定でも大前提として説明している。
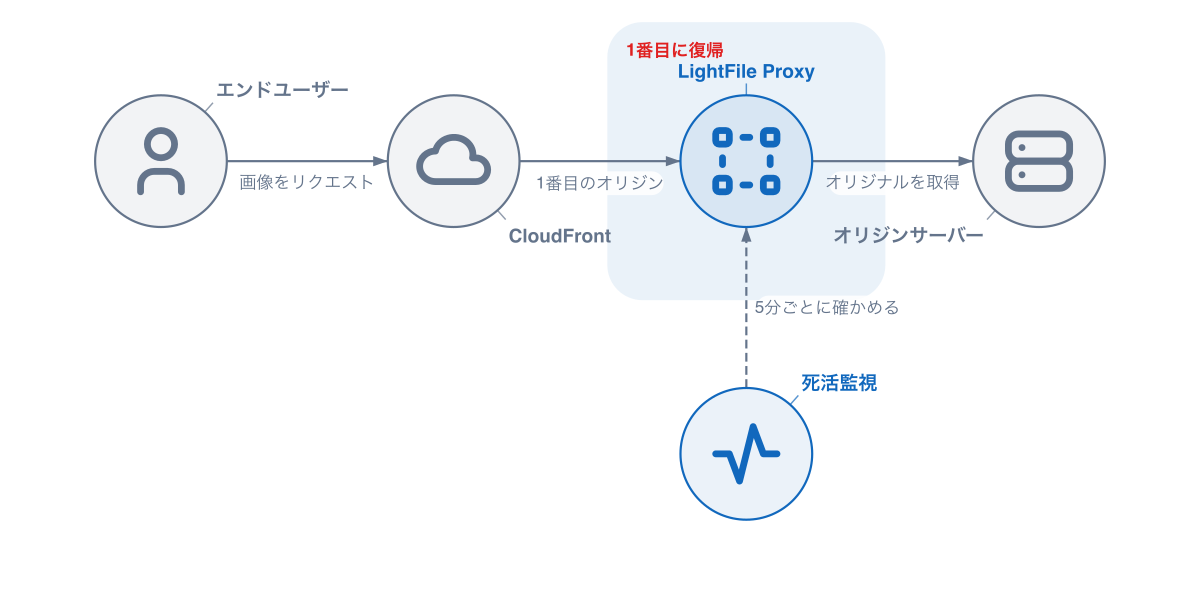
LightFile Proxyを1番目、本来のオリジンサーバーを2番目に登録する。平常時の経路はこうなる。
LightFile Proxyが503を返すと、CloudFrontは2番目のオリジンサーバーへ取りに行く。
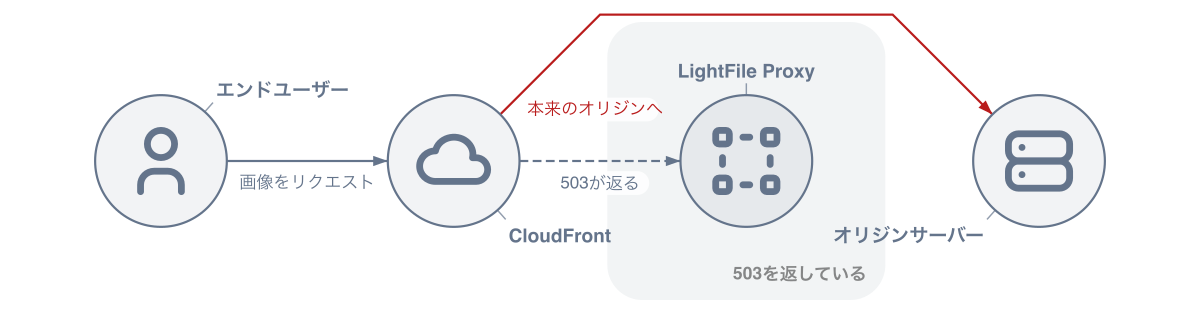
エンドユーザーから見ると、画像がWebPではなくJPEG/PNG/GIFで届くだけになる。リンク切れにはならない。
導入のときにこのオリジングループを必ず設定してもらっているのは、この土台がないと以下の備えがどれも働かないからだ。
瞬発的な障害回避はリクエスト単位で経路から外れる
一段目は、LightFile Proxy自身が「いまは自分を通さないほうがよい」と判断して503を返す動きになる。2つの場面がある。
応答が遅くなったとき。 直近のリクエストの平均応答時間を見ていて、3秒以上になったら503を返す。遅いまま返し続けるより、軽量化を諦めて速く返すほうを選んでいる。2023年4月から入れている。
ディスクが逼迫したとき。 変換済みの画像を置いているディスクが埋まりかけたときも503を返すが、このとき cache-control: no-store を付ける。
no-store が要るのは、CloudFrontが5xxの応答を10分間キャッシュするからだ。何も付けずに503を返すと、ディスクの問題が30秒で解消しても、CloudFrontは10分間そのエラーを覚えていて迂回が続く。復旧したのに戻ってこない状態になってしまう。no-store を付けておけば、回復した直後のリクエストから通常の経路に戻る。
長期的な障害への自動対応はCloudFrontの設定を書き換える
ここまでは、LightFile Proxyが応答を返せる状態であることが前提になっている。完全に止まってしまえば503すら返せない。
そこで別系統の死活監視を回している。5分ごとに、クラスタのping.jpgへ6秒間隔で5回リクエストする。5回とも失敗したらダウンと判定する。
死活監視はLightFile Proxyのクラスタとは独立して動いている。外から叩いて様子を見ているだけなので、LightFile Proxyがどんな状態でも死活監視は止まらない。クラスタが丸ごと落ちても、縮退の判断と操作はこちらで進む。
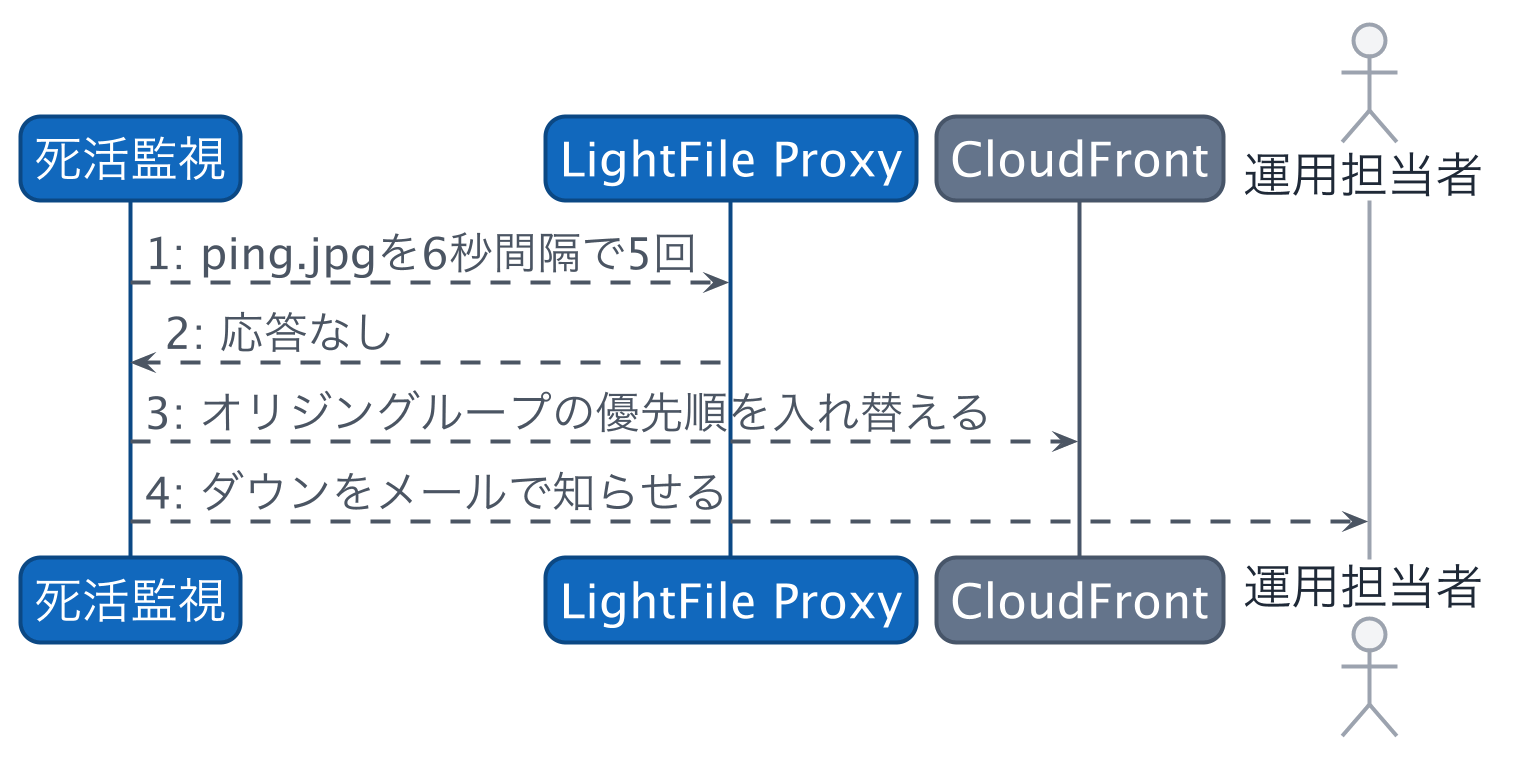
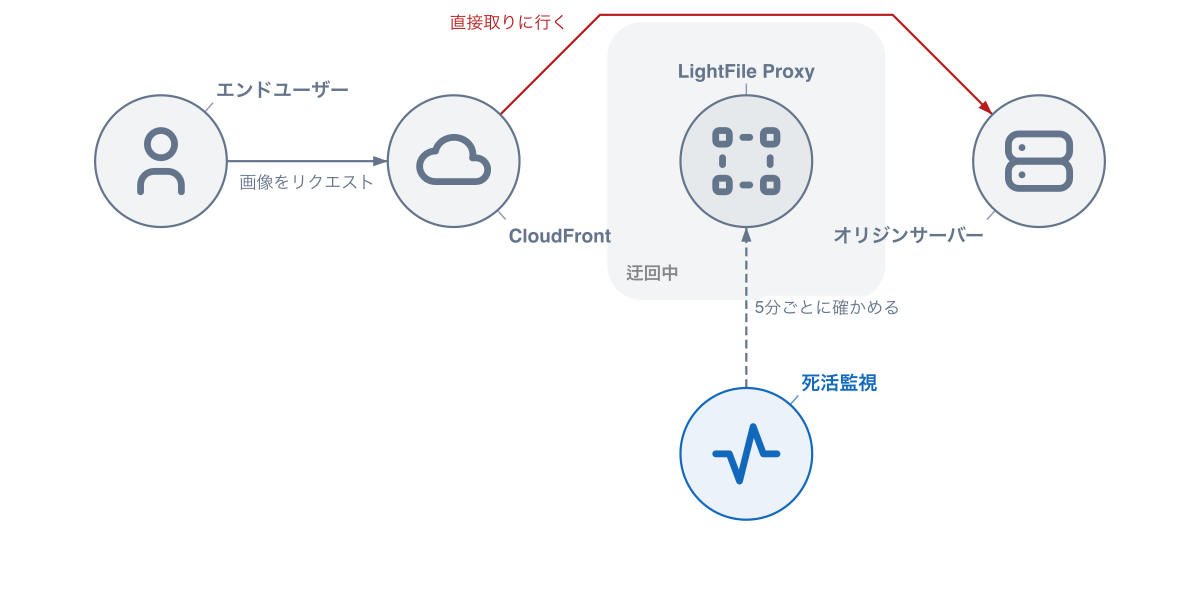
ダウンと判定すると、お客様のCloudFrontのオリジングループの優先順をAPIで入れ替える。本来のオリジンを1番目、LightFile Proxyを2番目にする。こうするとCloudFrontはLightFile Proxyに触れなくなり、配信は元の経路だけで続く。
関係を図にするとこうなる。死活監視がダウンを見つけ、CloudFrontに切り戻しを指示し、あわせて運用担当者にメールを送る。
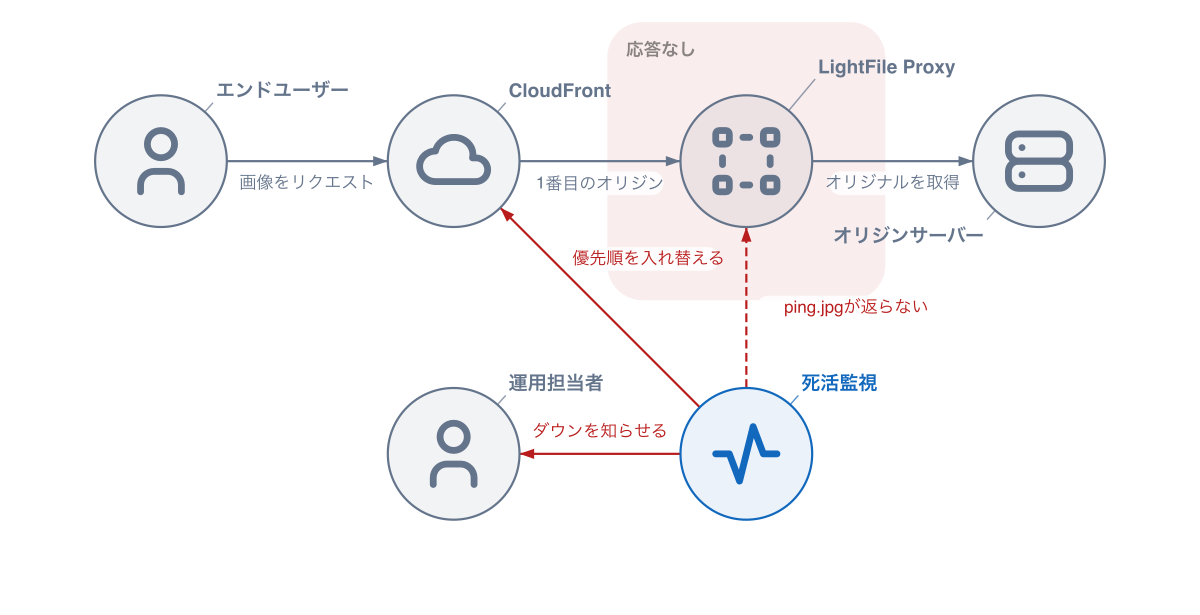
切り戻しが済むと、CloudFrontはLightFile Proxyへ取りに行かなくなる。画像はオリジンサーバーから直接配信され、死活監視だけがLightFile Proxyを見続ける。
いくつか補足しておきたい。
- お客様のCloudFrontの操作は、お客様のアカウントに用意してもらったIAMロールを弊社側がAssumeRoleで借りて行う。 権限を預かる形なので、何をするロールなのかは導入時に確認してもらっている
- リハーサルができる。 実際に障害が起きる前に、入れ替えが通るかどうかを試せる。権限やIDの設定ミスは、このときに見つかる
復旧も人手を介さず経路を戻す
縮退したままでは軽量化が止まったままになる。復旧の検知も同じ死活監視が担当する。
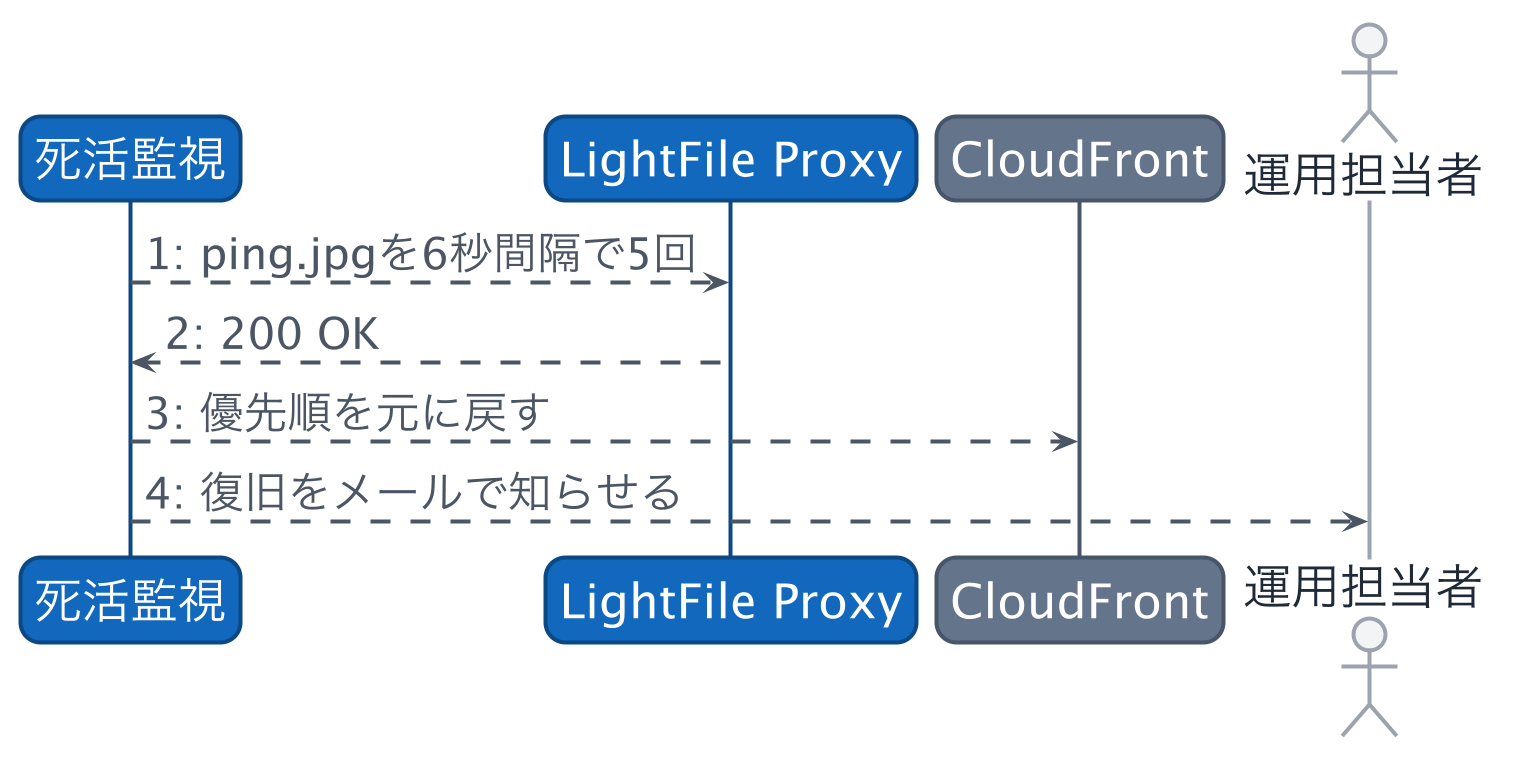
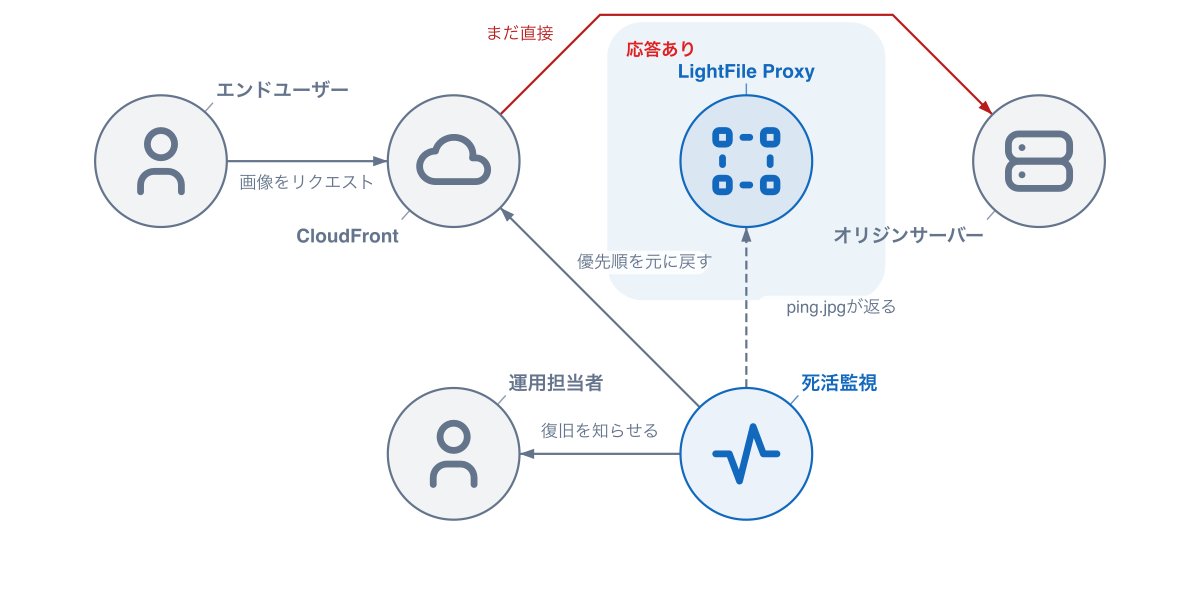
ping.jpg が返るようになれば、オリジングループの優先順を元に戻す。ダウンのときと復旧のときで、どちらの操作を自動で行うかは個別に設定できる。たとえば「縮退は自動、復帰は人が確認してから」という運用も選べる。
優先順が戻ると、配信はまたLightFile Proxyを経由するようになる。ここまで人の操作は要らない。
ダウンと復旧のどちらでも運用担当者へメールを送る。経路が勝手に切り替わったのを知らないまま、というのが一番困るからだ。
瞬発的な503による迂回のほうは、この操作をしなくても自動で戻る。503を返さなくなればCloudFrontは1番目のオリジンに戻り、no-store を付けているので待ち時間もない。
夜中に落ちても誰も起こされない
ここまでの仕組みが効いているとき、外から見える変化はWebPがJPEG/PNG/GIFに戻ることだけになる。LightFile Proxyが止まっても、画像が表示されないというトラブルにはならない。
長く続く障害でも同じだ。深夜に落ちても、運用担当者が緊急で対応することはない。 死活監視が縮退まで済ませ、直れば経路を戻すところまで自動で終わっている。朝に届いているメールで、夜のあいだに何が起きたかを知ればよい。
この記事での解説は、あくまでLightFile Proxy自体の障害対策である。言うまでもないが、オリジンサーバー自体やAWS全体の障害となるとお手上げとなる。