
余っていたグラフィックボードで、ローカルLLMの環境を少しずつ整えている。そこまで高性能なものではない。その中で、音声合成モデルの Qwen3-TTS を使うと、自分の声で好きなテキストを読み上げさせられるという話を聞いた。これは試すしかない。
まずは聴き比べてみてほしい。片方は私が実際に読んだ録音で、もう片方は私の声をまねてAIが読み上げたものだ。
「お使いのサイトで、いちばん重いページがどこか、ご存じですか?…」
| 読み手 | 音声 |
|---|---|
| 本人 | |
| AI |
「正直に言うと、最初に結果を見たときは本当に驚きました。…」
| 読み手 | 音声 |
|---|---|
| 本人 | |
| AI |
AIのほうは、別の文章を読んだ私の録音を30秒ぶん見本として渡しただけで、この2つの文章を私が読むのを聴かせてはいない。声色だけでなく、アクセントのくせまで自然に出ていて驚いた。
録音から比較までの手順とスクリプトはGitHubに置いてある。細かいことはこちらを読んでほしい。
miyanaga/my-voice-gen-experiment自分の声を録音し、ローカルのQwen3-TTSにまねさせて本人と比べる実験の一式github.comきっかけは動画広告のナレーション
最近、動画を素材にした広告をたくさん作っている。そのナレーションは Gemini の音声合成に頼んでいるのだが、どうしても「どこかで聞いた声」になる。
自分の声を見本にして読み上げを作れたら面白いのではないか、というのが始まりだ。
使ったもの
- 音声合成: Qwen3-TTS 1.7B Base(Apache 2.0)を8bitに量子化したもの。audio.cpp で動かした
- GPU: GTX 1080 Ti(11GB)。2017年のカードだ
- 書き起こし: Whisper(読み間違いを数えるため)
- 声の近さ: WavLM(声の特徴を数値にして、本人の録音との近さを測るため)
録音と生成した声は、手元のPCとローカルのサーバーから外には出していない。
速さも十分だった。15〜20秒の音声を8秒ほどで作れる。古いGPUでも、読み上げにかかる時間の半分で済む。
実験のやり方
用意した原稿を、iPhone のボイスメモで通して読んだ。2分ほどの録音で、中身は2種類に分かれている。
- 見本用: 約3秒・10秒・30秒の3本。AIに「この声でしゃべって」と渡す素材
- 比較用: 15〜20秒の6本(挨拶、数字、問いかけ、カタカナ語、感情、締め)。同じ原稿をAIにも読ませて、本人と比べる
見本と比較用の文章はわざと重ねていない。重ねると、まねではなく丸写しを測ることになる。
なお、モデルを学習させているわけではない。見本の音声を生成のたびに渡すだけで、その声で読み上げてくれる。
見本の渡し方は2通り試した。
| 渡し方 | 中身 |
|---|---|
| ICL | 見本の音声と、その書き起こしを渡す。話し方まで引き継ぐ |
| x-vector | 見本の音声から声の特徴だけを取り出して渡す。書き起こしは要らない |
見本の長さ3通り × 渡し方2通りの6条件に、比べる目安として「別人の声(モデルに最初から入っている話者)」を加えた7条件で、6本ずつ読ませた。
声の近さを並べてみる
本人の録音と、どれくらい声が近いかを数字にしたのが下のグラフだ。1に近いほど同じ声に聞こえる。
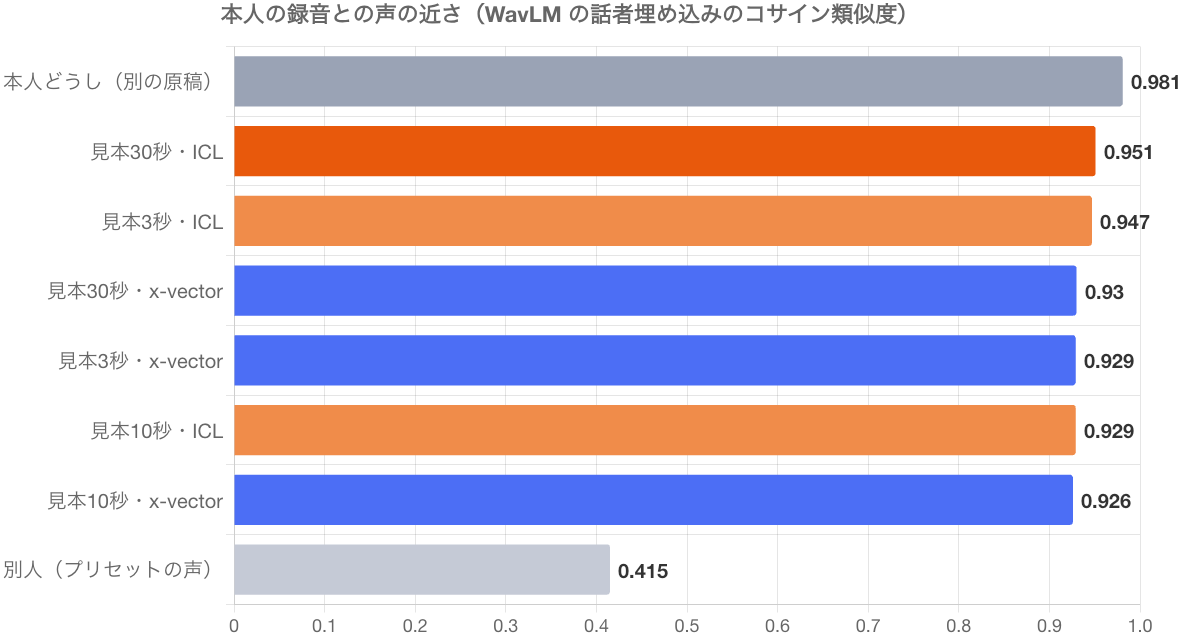
上限の目安は「本人が別の原稿を読んだ録音どうし」の0.981、下限の目安は別人の声の0.415だ。6条件はどれも0.93〜0.95で、本人のすぐ近くに並んでいる。
いちばん近かったのは見本30秒・ICLの0.951で、耳で聴いても私の印象はこれがいちばん本人らしかった。冒頭の聴き比べもこの条件で作っている。
ただし、条件ごとの差はわずかだ。見本が3秒しかなくても0.947出ていて、長くすればするほど似る、というほど単純ではなかった。
読み間違いもほとんどなかった。Whisperで書き起こして原稿と比べると、AIの誤りは1.5〜1.7%で、本人の録音(2.2%)より少ないくらいだった。
OpenAI・Anthropic・Geminiではどうか
同じことを大手のAPIでできないか調べてみたが、思ったよりも手軽ではなかった。
- Anthropic: 音声を生成するAPIがそもそもない
- OpenAI: Custom voices があるが、対象の顧客に限られ、営業への問い合わせが必要
- Gemini: Voice replication がある。ただし見本とは別に、決められた同意の文を本人が読み上げた録音を用意する必要がある。地域によっては使えない
OpenAIとGeminiでは使えるものの、どちらも本人確認の手続きを厳しくしている。自分の声で気軽に試すなら、ローカルのモデルか音声に特化したサービスのほうが早い。
音声モデルはLLMほど重くない。今回のモデルは11GBのGPUに余裕で収まった。メモリをある程度積んだMacでも動かせるのではないかと思う。
危ない技術でもある
これはまさにディープフェイクだ。家族の声を手に入れて電話で詐欺をはたらく手口が話題になっているが、30秒の録音でここまで似るなら、悪用されればかなり危ない。
試すなら自分の声か、本人の同意を得た声だけにしてほしい。私も、録音とそれをまねた声は、この記事に載せた4本を除いてどこにも公開していない。
危ない技術ではあるが、実験としてはとても面白かった。次は動画広告のナレーションを自分の声で作ってみるつもりだ。